Progetto concluso / ricerca, RAG e agenti
RAG: scegliere come cercare e rispondere.
Ho confrontato recupero, riordinamento e generazione su domande finanziarie. Un banco delle decisioni raccoglie qualità, tempi e costi delle alternative, distinguendo le misure del progetto dai dati esterni.
La domanda guida: quali fonti arrivano davvero alla risposta, entro i vincoli di tempo e costo?
Trovare le fonti giuste
Un sistema RAG cerca brani pertinenti in un archivio e li passa al modello che scrive la risposta. Per capire se la ricerca funziona ho usato la parte finanziaria di MTRAG, che associa le domande alle fonti annotate.
Le annotazioni aiutano a misurare il recupero, ma non elencano ogni brano che potrebbe essere utile alla risposta.
il codice: recall e nDCG
Le due misure usate in tutto il progetto. La recall conta quante fonti giuste compaiono fra i primi dieci risultati; l'nDCG premia anche la posizione: una fonte giusta in cima vale più di una in fondo alla lista.
def recall_at(ranked_ids, relevant, k):
    return len(set(ranked_ids[:k]) & relevant) / len(relevant)


def ndcg_at(ranked_ids, relevant, k):
    dcg = sum(1 / math.log2(rank + 2)
              for rank, pid in enumerate(ranked_ids[:k]) if pid in relevant)
    ideal = sum(1 / math.log2(rank + 2) for rank in range(min(k, len(relevant))))
    return dcg / ideal if ideal else 0.0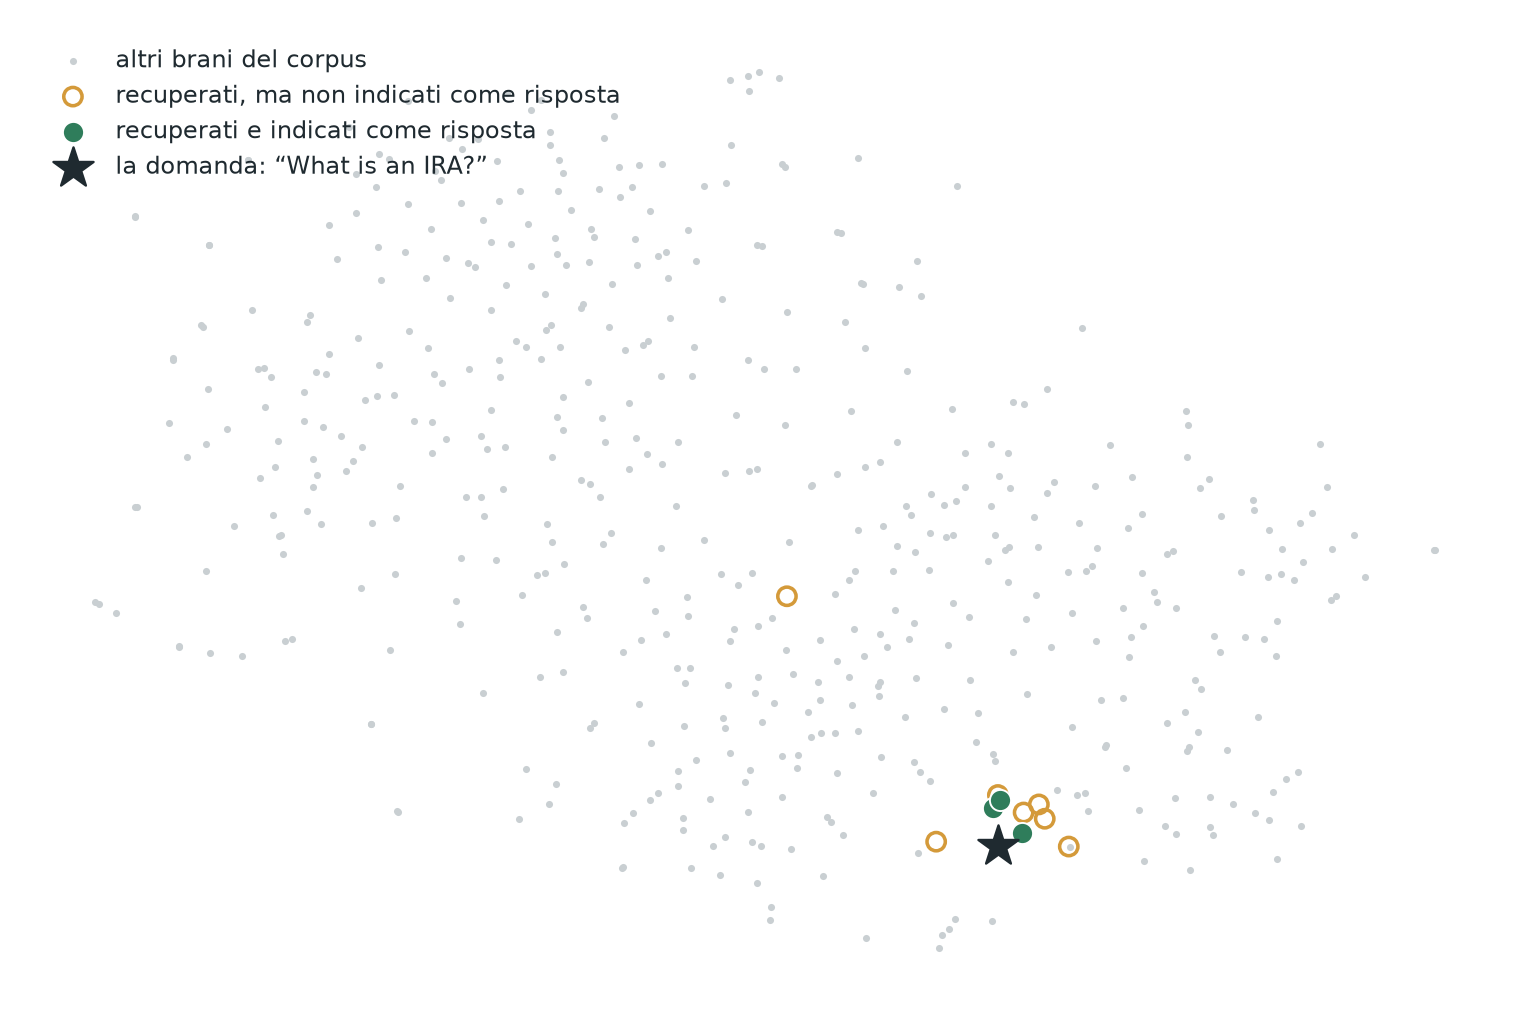
Un banco per decidere
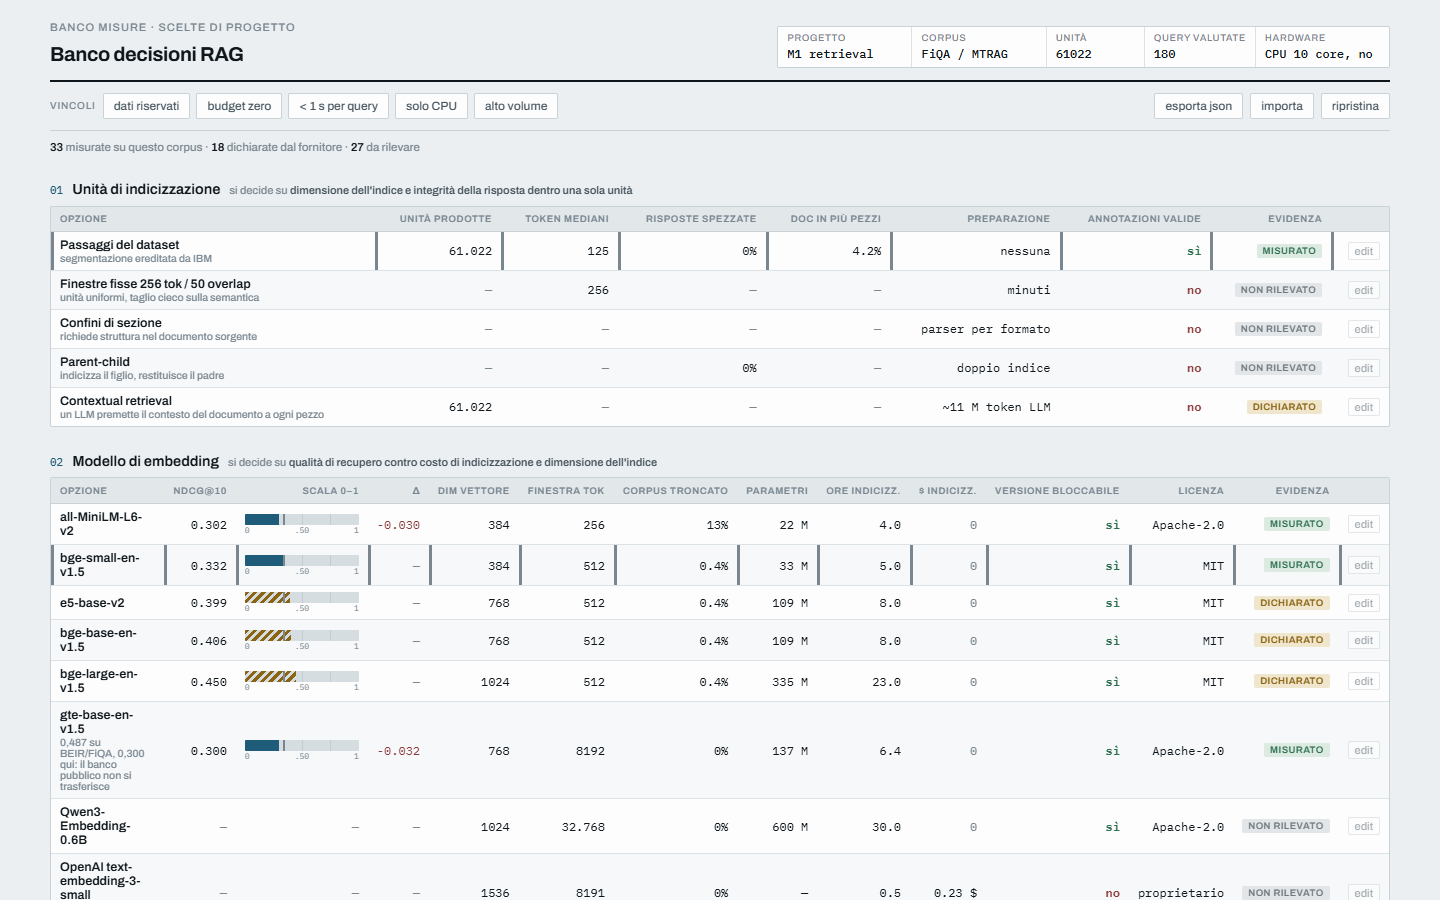
Il banco confronta modelli vettoriali, ricerca, riordinamento e generazione. Per ogni opzione mostra qualità, tempo, costo e provenienza dei dati; i vincoli del contesto filtrano le alternative.
Apri il banco e prova i filtri.
Quanti candidati riordinare?
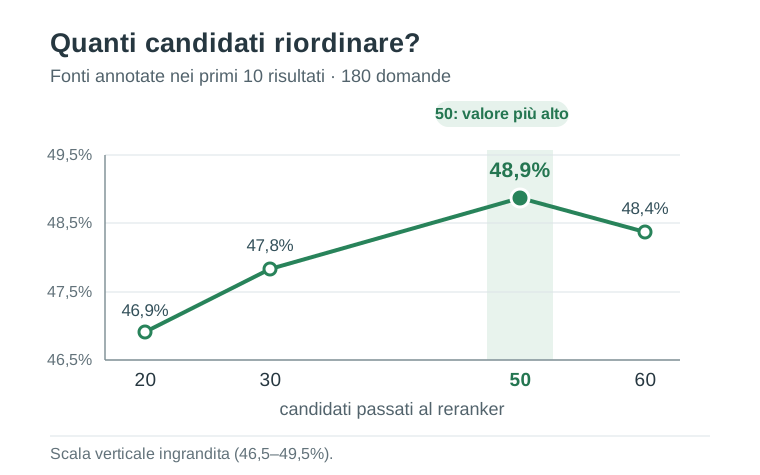
Il recupero propone i brani, poi un reranker ne rilegge una parte e mette i più utili in cima. Ho confrontato 20, 30, 50 e 60 candidati sulle stesse 180 domande: la misura è la quota di fonti annotate che arriva nei primi dieci risultati.
Ho scelto 50 candidati: è il miglior risultato osservato, 48,9% contro 47,8% a 30. La differenza è modesta e gli intervalli di incertezza si sovrappongono.
il codice: dai brani ai vettori, e la ricerca
Ogni brano dell'archivio diventa un vettore una volta sola; a ogni domanda si codifica solo la domanda e la si confronta con tutti i brani con un prodotto scalare. La versione del modello è fissata, perché un aggiornamento dei pesi cambierebbe i risultati.
self.model = SentenceTransformer(model_name, revision=revision, device="cpu")

# Vettori normalizzati a lunghezza 1: il prodotto scalare è la similarità coseno.
self.embeddings = self.model.encode(
    [p.indexed_text for p in passages],
    batch_size=batch_size,
    normalize_embeddings=True,
)

def search(self, query, top_k=10):
    query_vector = self.model.encode(
        [self.query_instruction + query], normalize_embeddings=True)[0]
    scores = self.embeddings @ query_vector      # la domanda contro tutti i brani
    order = np.argsort(-scores, kind="stable")[:top_k]
    return [RankedPassage(self.passages[i].passage_id, float(scores[i])) for i in order]
Da src/retrieval.py.
il codice: il riordinatore
Nella configurazione finale ho mantenuto fissi modelli e domande; ho variato solo quanti brani passare al reranker.
for d in RERANK_DEPTHS:  # 20, 30, 50, 60
    per_q = []
    for i, g in enumerate(gold_ranks):
        order = np.argsort(-sc[i][:d], kind="stable")
        pos = {int(p): r + 1 for r, p in enumerate(order)}
        per_q.append(metrics([pos[r - 1] if r <= d else r for r in g]))
    record(f"reranking sui primi {d}", per_q)
Adattato da esperimenti/studio-embedding-retrieval/16_configurazione_finale.py.
Dalle fonti alla risposta
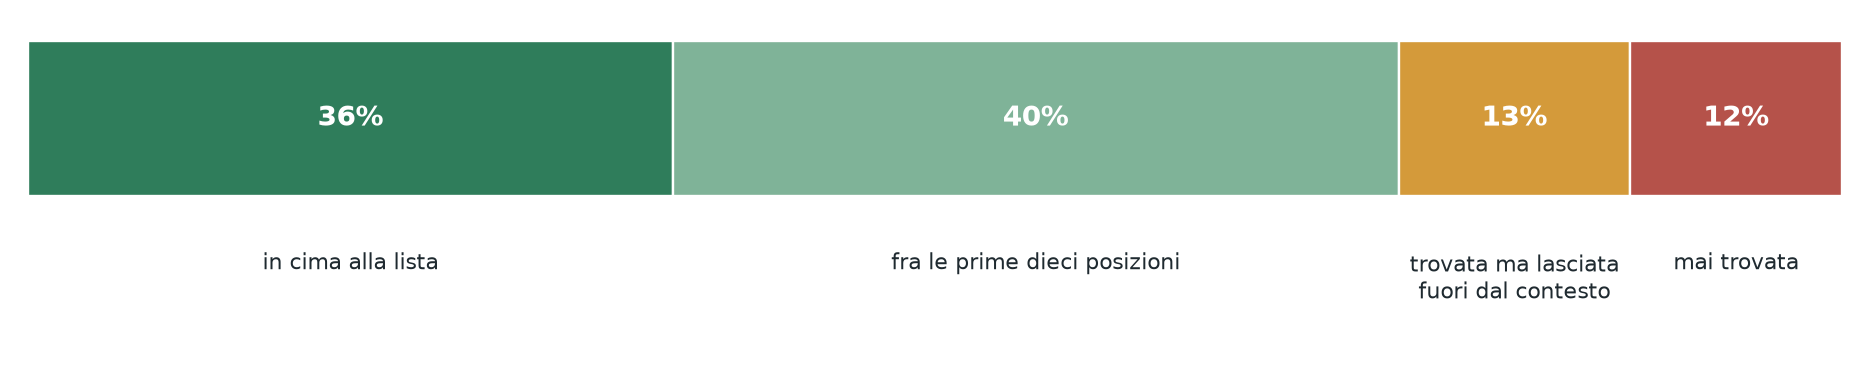
Una fonte può comparire nei risultati della ricerca e restare fuori dal contesto che il modello legge. Ho seguito questo passaggio e confrontato le risposte generate, oltre alle metriche di recupero.
La configurazione migliore in media portava meno fonti utili per alcune domande: nelle risposte la differenza emergeva soprattutto nella completezza.
Ricerca a più passi e sintesi anticipata
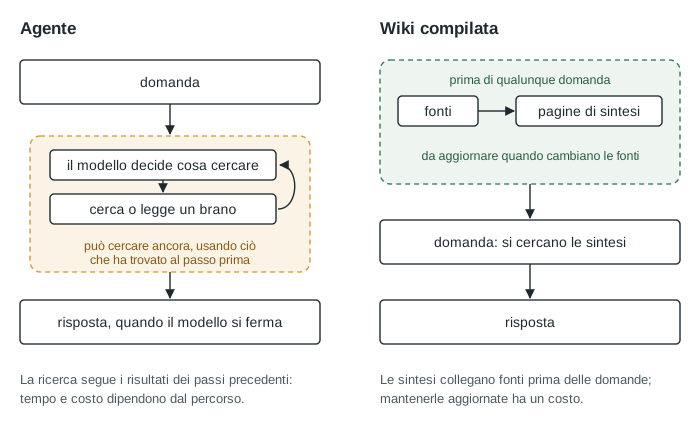
Nel RAG studiato il recupero precede la risposta. Un agente può cercare ancora in base a ciò che trova, utile per domande a più passaggi. Una WikiLLM prepara sintesi tra documenti prima delle richieste ricorrenti.
La scelta dipende dal tipo di domanda, dal tempo disponibile e da quanto spesso cambiano le fonti.